AI 新定制 - 评测&匹配系统探索
目录
本文源自公司内部项目实践,相关数据已做脱敏处理。
财年初我们小组尝试起一个新的项目,AI 新定制,期望通过接入 AiAgent 的能力、以及我们的自建定制知识库、前台产品、匹配能力等来期望能够更好的承接买家定制诉求。
核心的业务链路为: 用户提出定制诉求 -> 借助 Agent 以及我们的 skills 进行需求澄清(skills 中会接入我们的定制知识库作为事实依据) -> 澄清完毕以后生成定制需求摘要 -> 交由我们的定制匹配系统匹配对应的商家或者商品。
原本我只负责其中的评测部分,也就是当我们产出了一个定制解决方案 skills 以后如何评估我们的这套系统和国际站现有的定制承接体系的差异,在评测完成以后后续由于人员变动,我也负责了匹配链路的开发。
一、评测系统:建立一套共同的判断标准
设计时,原本同时考虑了黑盒、白盒和在线观测:分别比较最终推荐结果、检查理解与召回等内部环节,以及观察点击、询盘等买家反馈。但当时产品尚未上线,需要先知道各方案能做到什么程度,因此先实现黑盒评测。
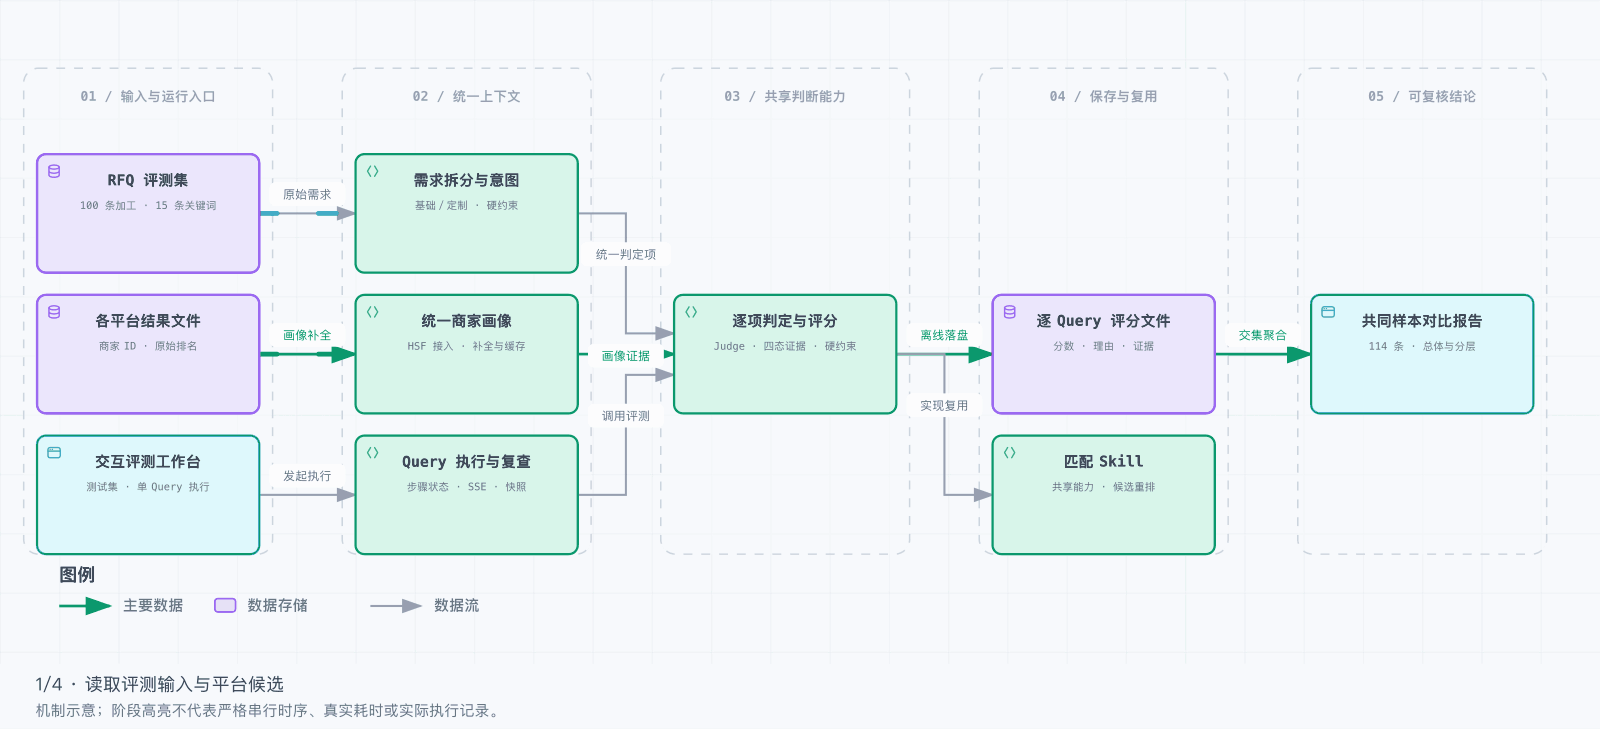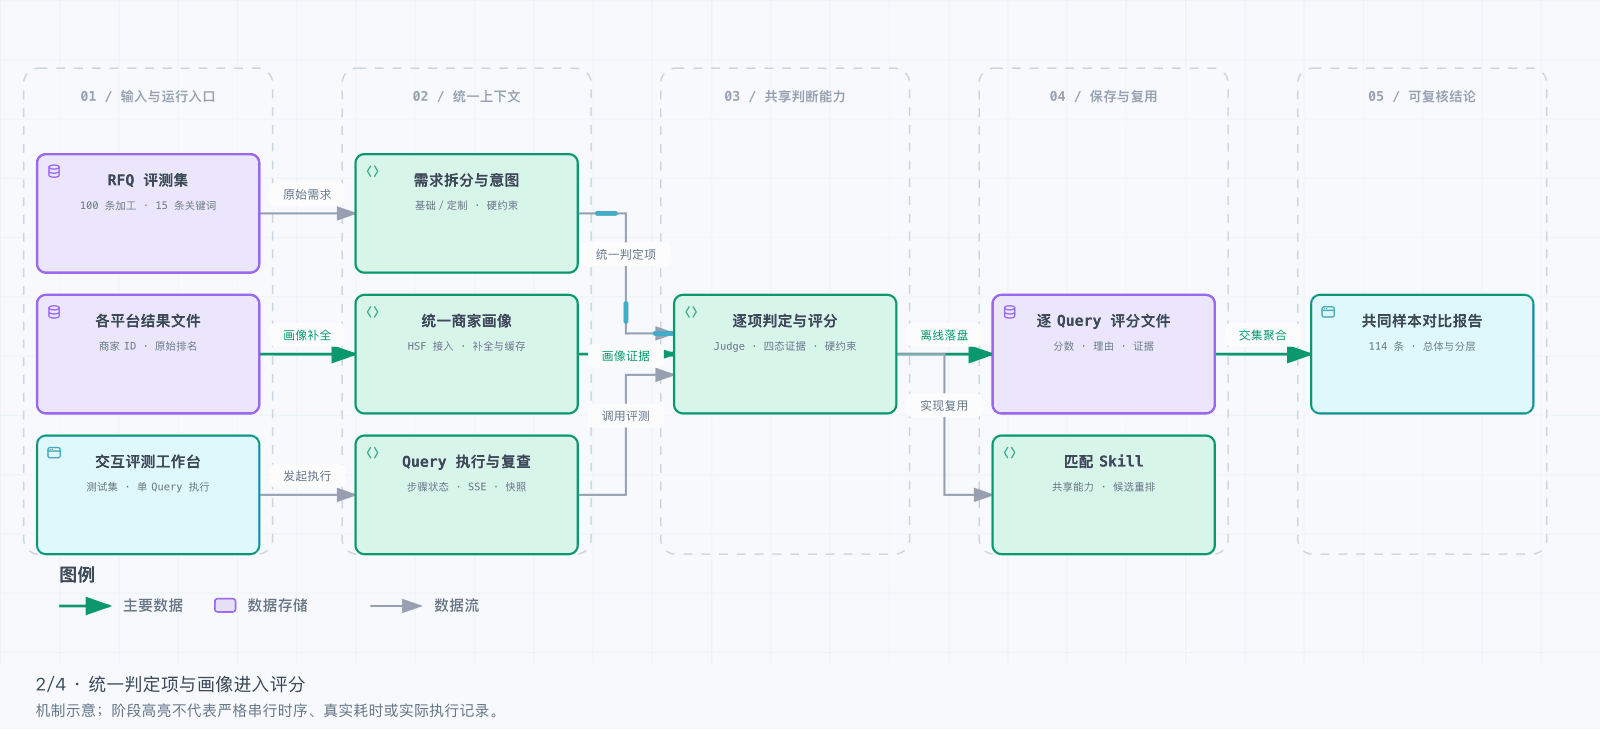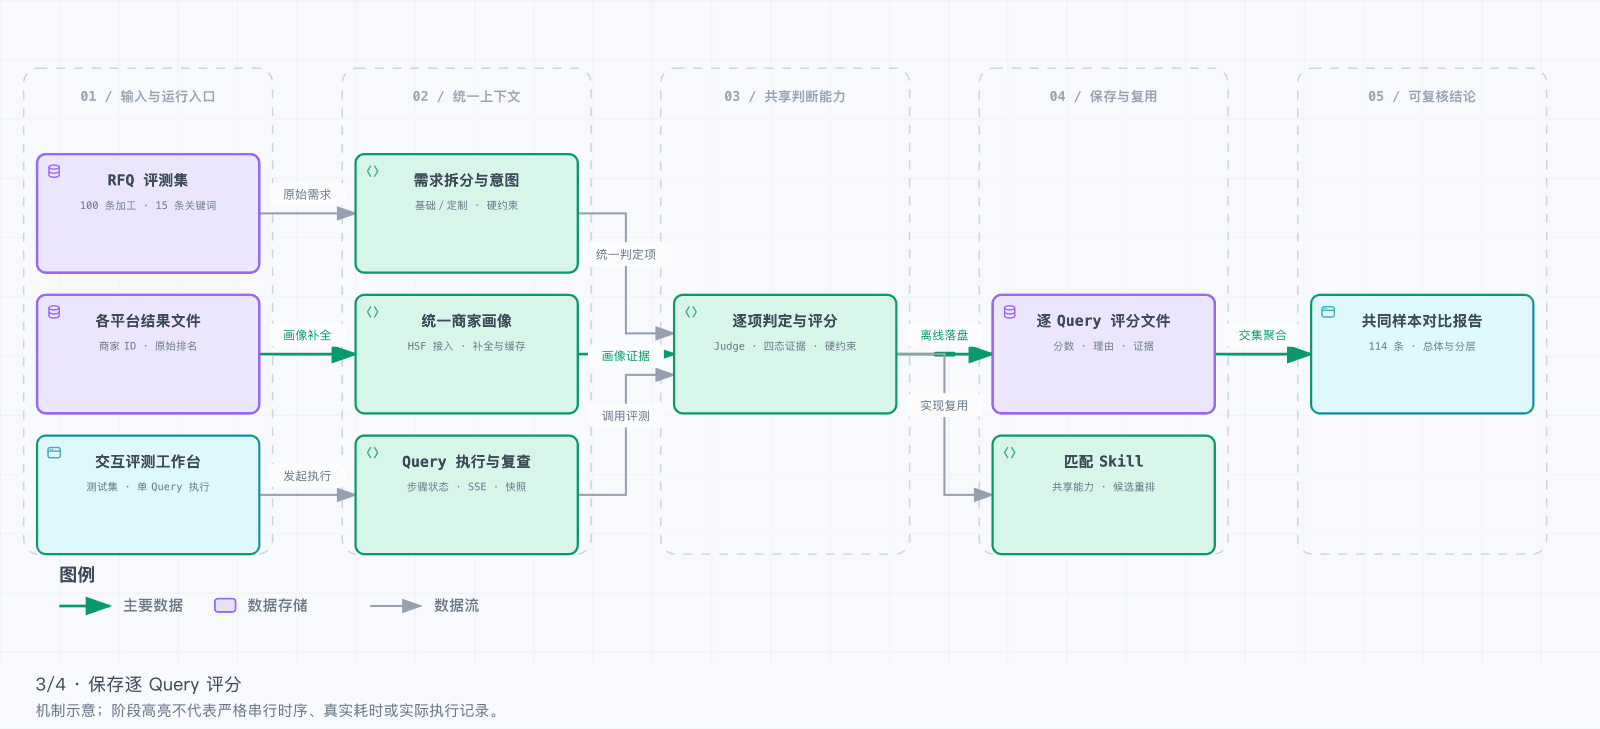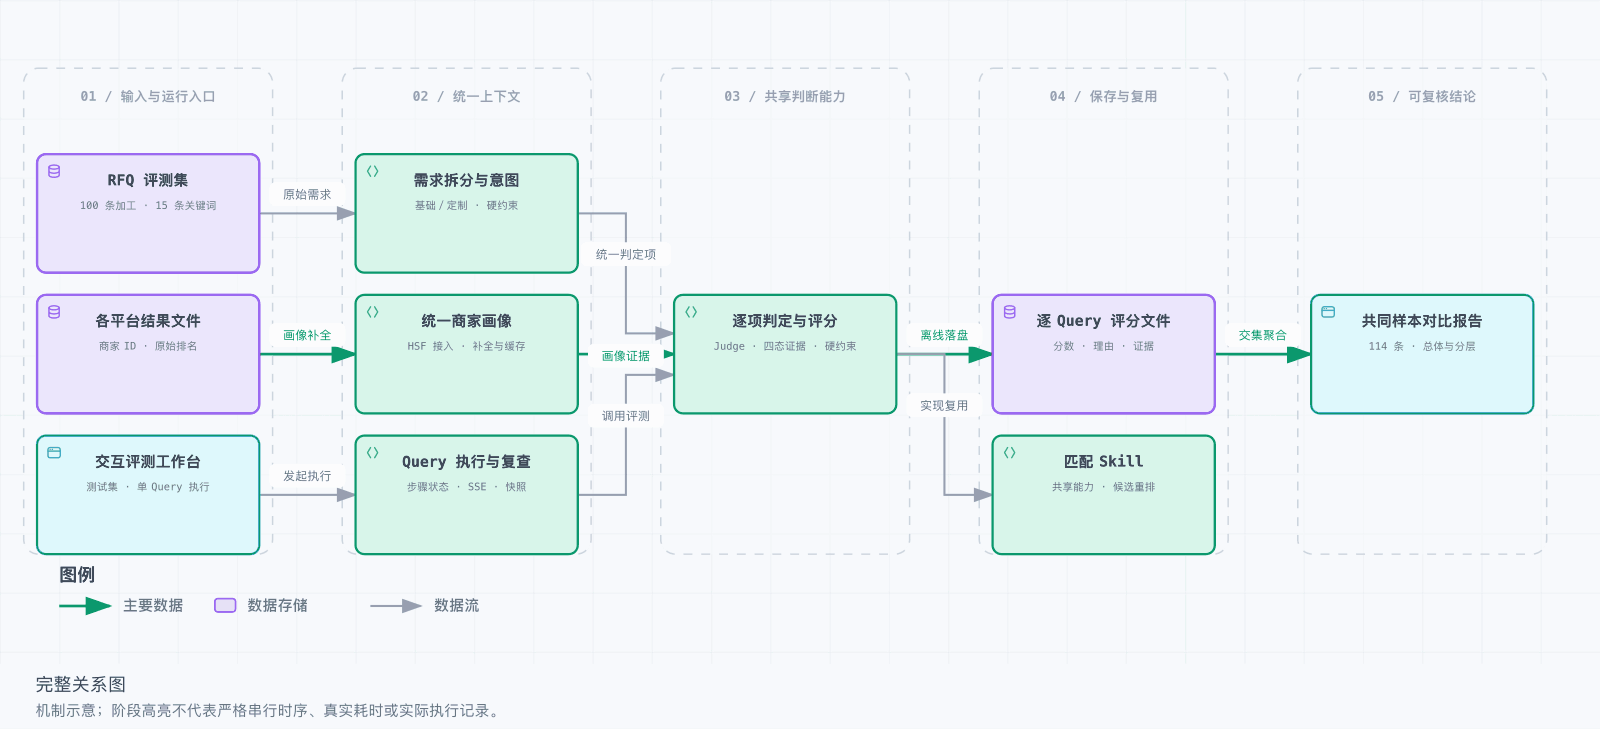
黑盒评测将同一需求交给几个系统,按统一标准判断它们返回的商品或商家,再比较结果。为此需要四部分:
- 测试 Query:准备有来源、覆盖不同定制深度的共同输入。
- 候选采集:调用搜索或 Agent,取回候选、顺序及判断所需的资料。
- Judge(评判模型):将需求拆成判定项,结合品商能力画像逐项判断,留下理由与证据。
- 评分和报告:从候选分、单 Query 得分逐层汇总,比较系统差异。
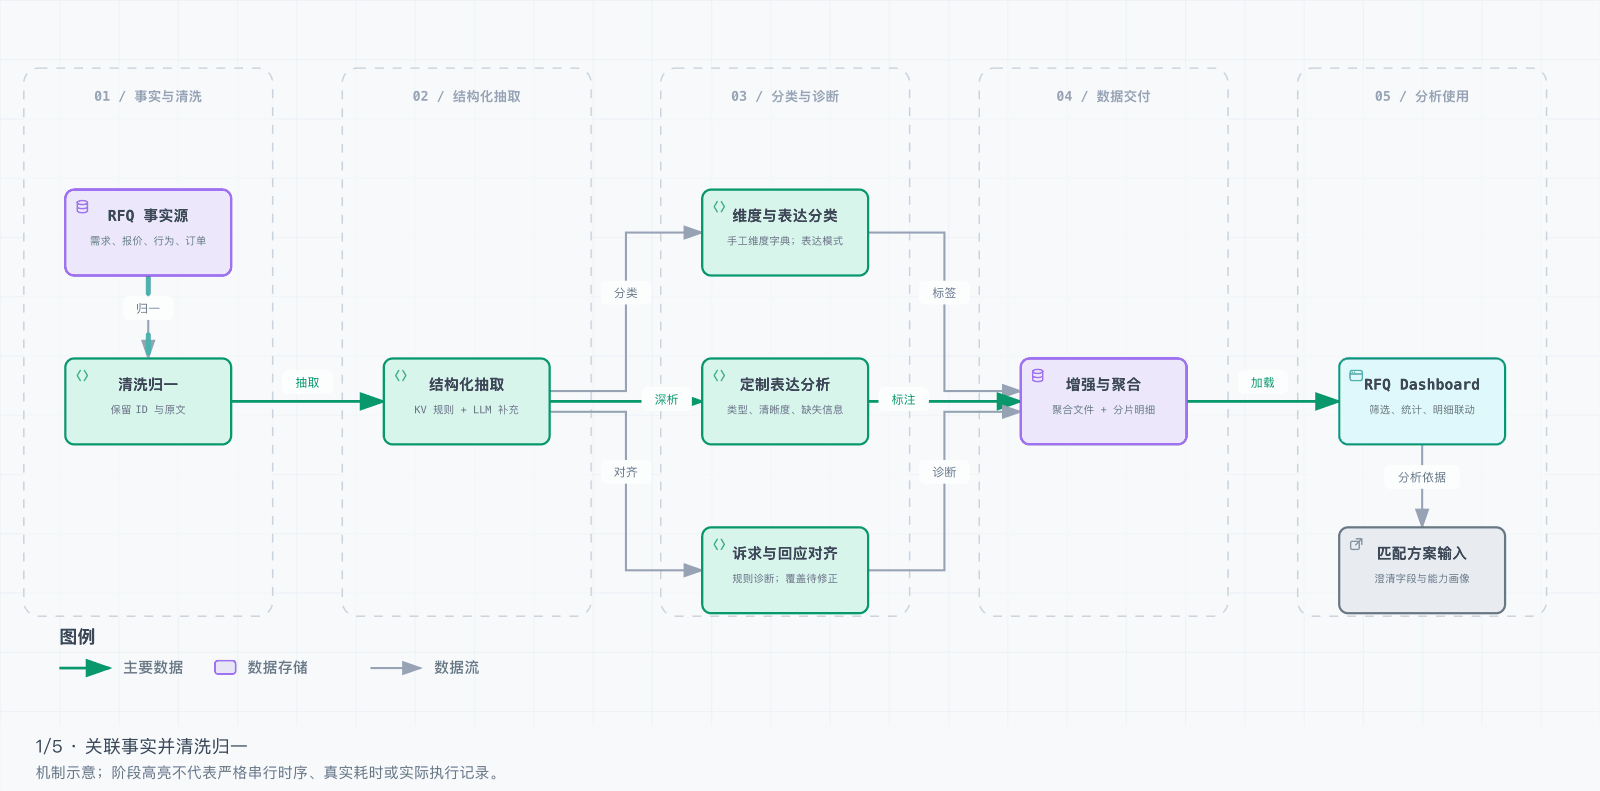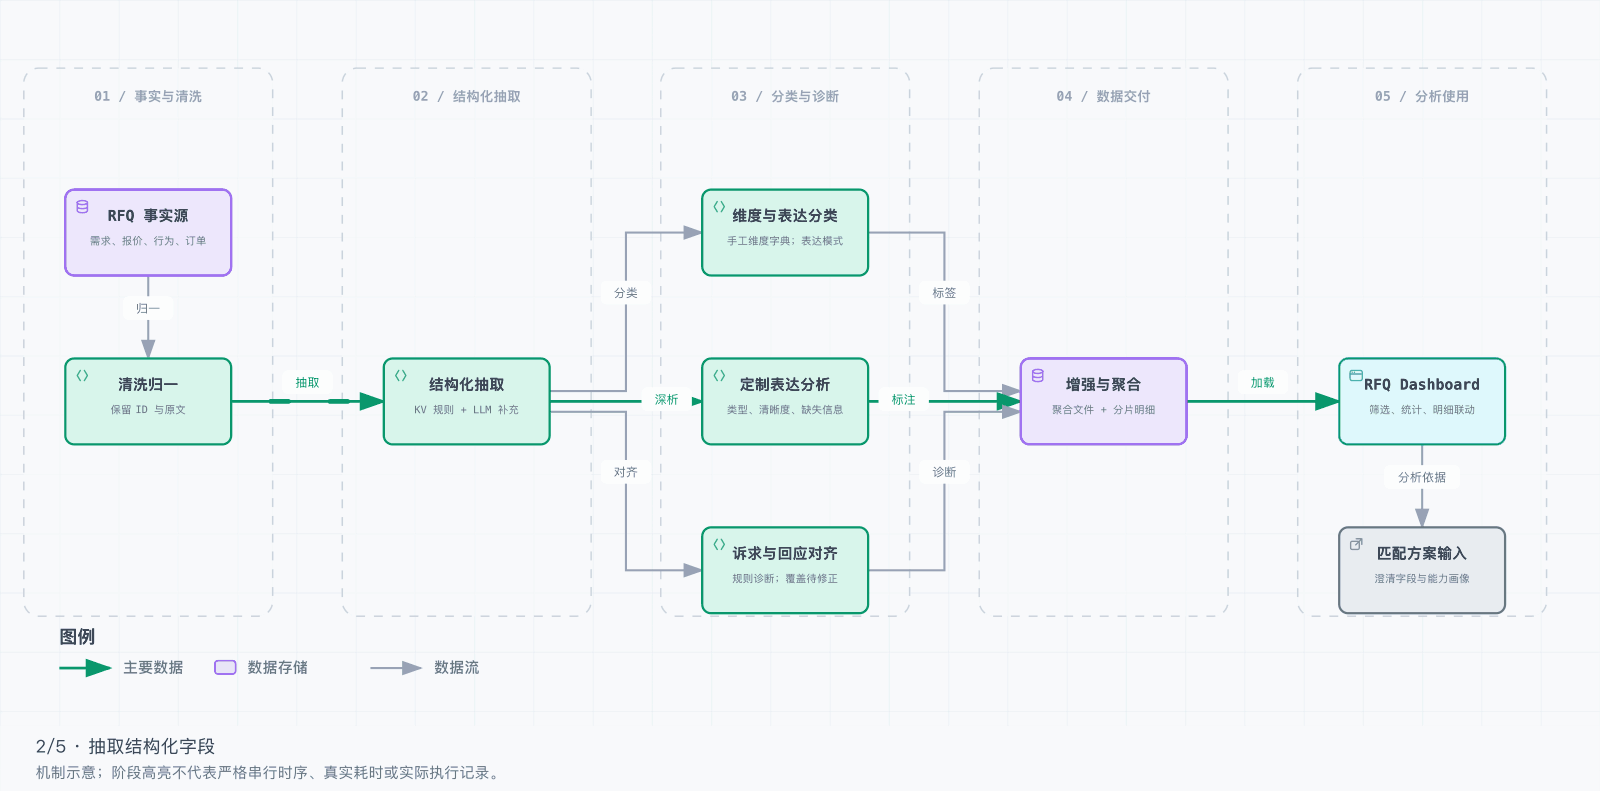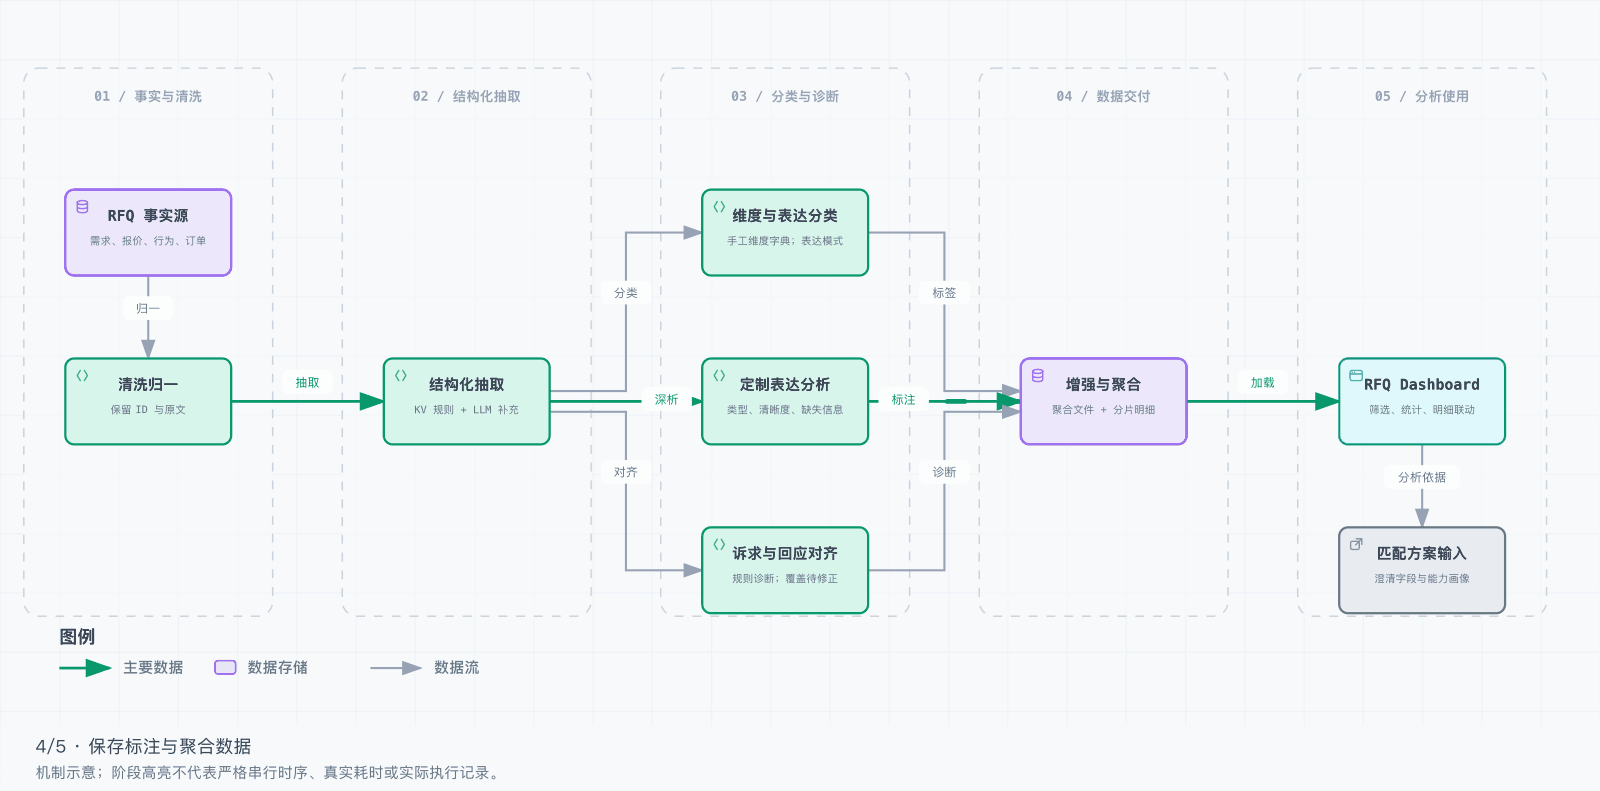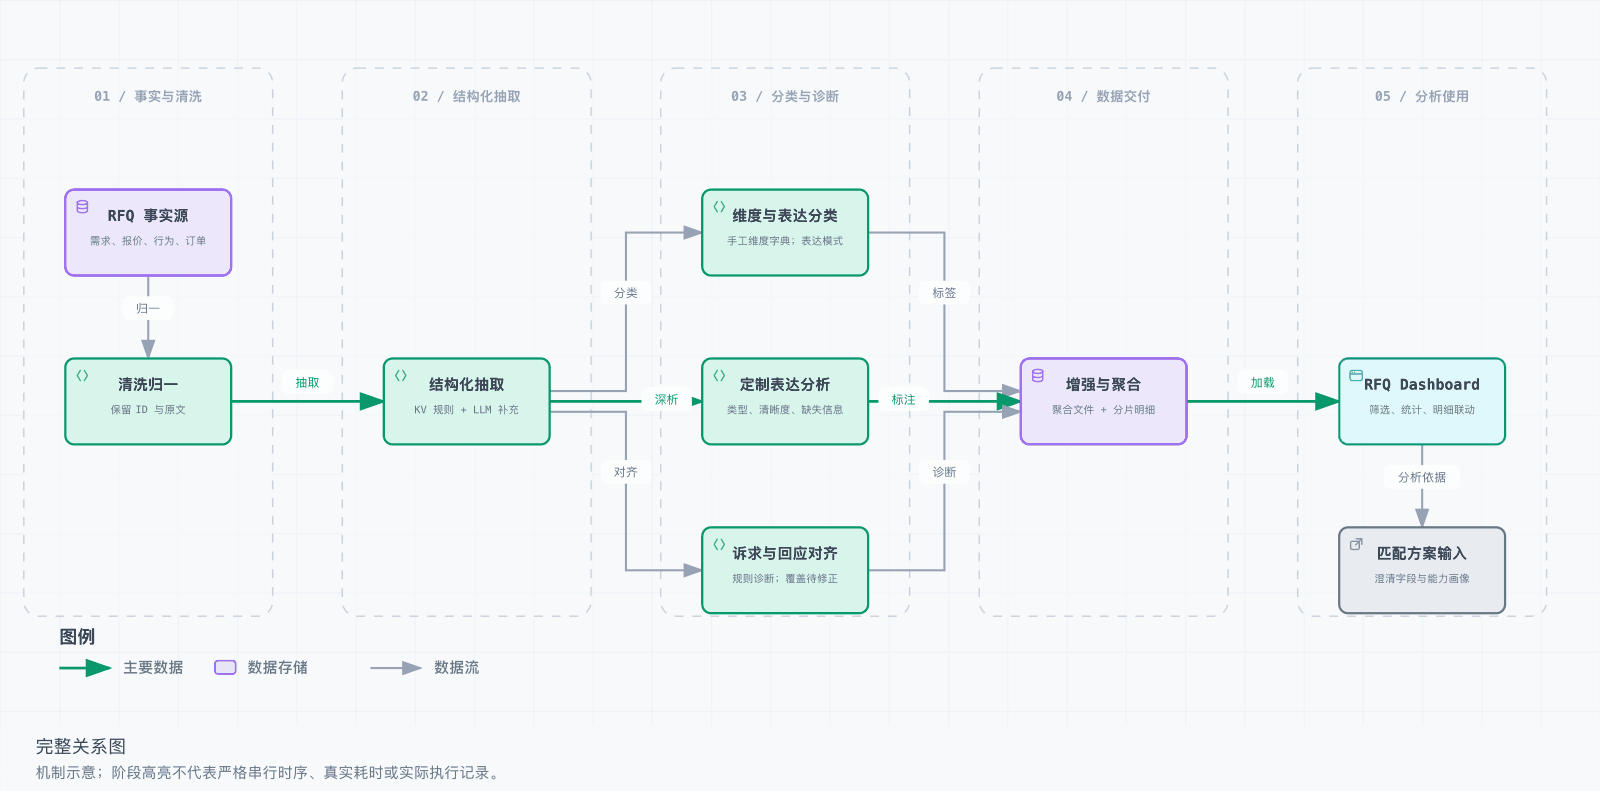
整体系统流程如下图:
1.1 测试 Query 分级
我们原计划一期关注在机械和服装行业,所以我先拿机械行业进行试手。选择 RFQ 作为来源,因为其中包含品类、规格、定制要求和采购条件,适合检查系统能否处理多项约束,可以参考我对 RFQ 数据的分析结果:
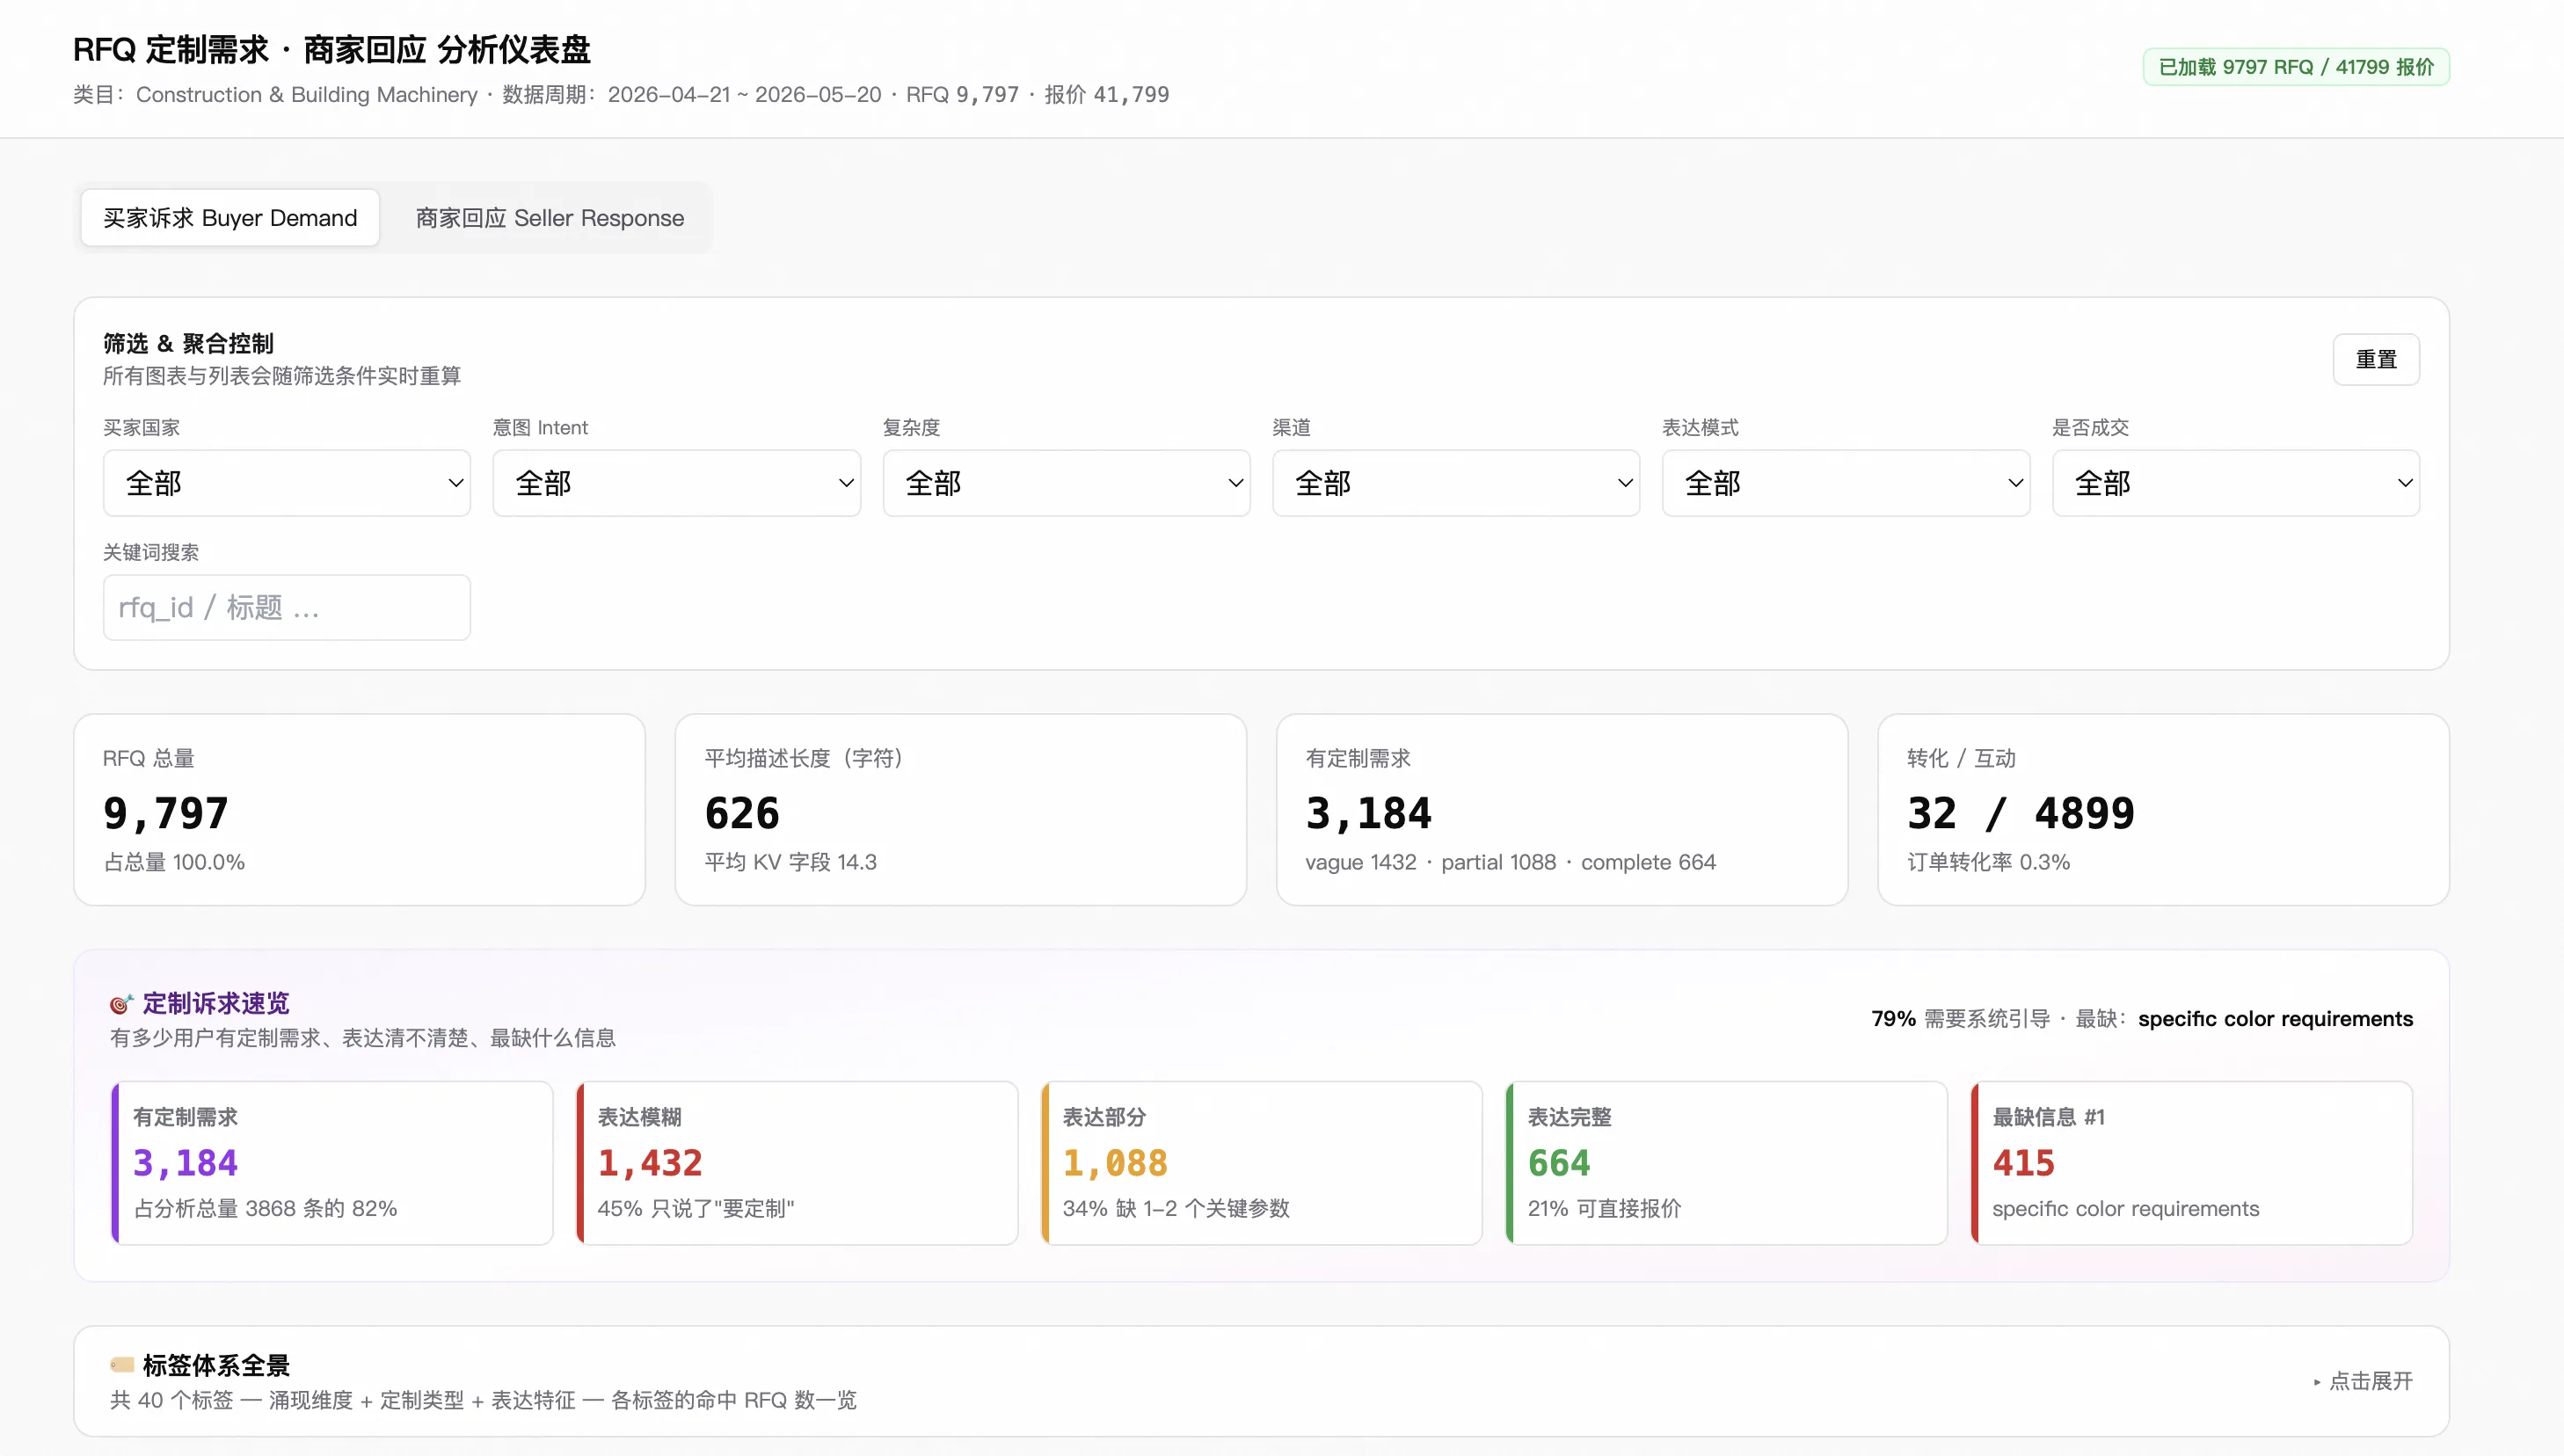
第一批从 RFQ 加工数据中取得 100 条需求,再从 RFQ 名称中提炼 15 条搜索关键词,共形成 115 个 Query ID,保存文本、来源、行业和等级。如果只测短关键词,看不出定制理解能力;只测复杂需求,又无法判断基础搜索是否退化。因此,我按定制深度设计了 L1~L4:
| 等级 | 需求特点 | 设计示例 | 主要检验什么 |
|---|---|---|---|
| L1:普通搜索 | 标准品类,没有显式定制意图 | 不锈钢水杯 | 能否找到相关供给 |
| L2:明确约束 | 品类明确,规格和采购条件可以逐项核对 | ABS 接线盒,IP67,UL 认证,MOQ 500 | 能否同时满足参数与采购条件 |
| L3:模糊定制 | 有定制意图,但要求不完整或不够精确 | 为自有品牌定制印花瑜伽裤,小批量 | 能否识别定制诉求,并区分已有条件与待澄清信息 |
| L4:复杂定制 | 多维定制、工艺改造或较强的专业约束 | 来图来样开模,双色注塑,同时满足防护与认证要求 | 能否理解深层约束,并找到具备联合承接能力的供给 |
分级主要是看定制深度:一句话要求重新开模,也可能是 L4;列出很多标准参数,未必就是深度定制。分层后,可以更加细致的看到我们的系统在不同定制深度下的表现,可以更好的指导后续的优化方向。比如如果系统在普通搜索表现不错、复杂定制却较弱,就应重点检查专业条件有没有拆全、画像能否支持判断,而不是只看总分继续改搜索词。
我们最终报告使用的 query 实际 L1/L2/L3/L4 分级为 15/9/61/30 ,都是机械行业;
1.2 不同匹配结果的获取
Query 确定后,采集层负责适配搜索页面、接口和 Agent 结果文件,取回候选 ID、顺序及原始结果,为后续的 judge 提供数据来源。我们主要对比了:Alibaba 搜品、Alibaba 搜商、AccioWork、以及 Claude Agent + Alibaba 搜索/搜商。下面是主要的几个平台的数据获取方式:
Alibaba 搜品/搜商: AlibabaProductSearch 和 AlibabaSupplierSearch 的数据来源稍有不同,搜品有 HSF 接口,而搜商没有,当时考虑到项目的实际情况,我们是做内部评测,所以也没有继续给搜索提搜商的 HSF 接口需求,采用了走 HTML 爬虫分析的方案。最终就是通过固定的 query ,看搜品和搜商分别返回的结果,过滤掉广告,提取商品和商家信息并保留顺序,最终存储到本地。
AccioWork AccioWork 是基于 Electric 开发的本地 APP,前端本质是一个 Chrome 浏览器内核,所以我直接使用 CDP 调试功能,来自动化进行 query 任务派发,每条 query 评测新建一个独立的 Accio 对话,保持干净上下文且不调用 Skills,避免任务之间相互影响,然后让它按照我们的诉求去匹配商家 or 商品,并返回固定格式的 json 文件,落到我们的系统中。以此使用 AccioWork 使用我们的 skills 和不使用的定制返回结果。
整理结果时保留导入后的候选顺序,平台推荐理由进行了留档方便后续人工 review,Judge 则依据统一补充的画像判断。同一商家可以复用画像请求,各平台列表仍分别保留,接下来比较候选满足了多少需求,以及合适的候选是否排在前面。
1.3 Judge 系统
获取每个系统同 query 的不同结果后,下一步就是对他们进行评分。
第一步,把 Query 拆成可以逐项判断的条件。
以前面说的生产线需求为例,包含整线、产能、模具、电压和售后等要求。我们将它拆成独立判定项,每项只回答一个问题,并区分要求类型和否决条件:
| 字段 | 作用 | 生产线案例 |
|---|---|---|
base | 品类、用途、规格等基础要求 | 完整生产线、原料粒度、设备电压 |
custom | 定制、改造或定制服务要求 | 可更换的定制模具、按电网要求定制电压 |
hard | 标记明确不满足时应当淘汰的条件 | 必须交付整线,必须支持指定定制能力 |
base/custom 区分要求性质,hard 是独立的否决标记,基础项也可以是硬约束。比如买家需要整线,商家只能卖单机,那么就属于 hard 诉求不符合,直接 pass 掉,其他参数符合也不能补偿这一点。
第二步,用能力画像逐项判断,再算候选分。
每一个候选的品商都会通过商品属性接口和 @树繁 提供的公司定制能力画像知识库补足品商画像,提供规格与定制能力证据。Judge 接收需求、判定项和候选画像,逐项输出状态、理由及可用证据,算出得分:
| 状态 | 判断含义 | 分值 |
|---|---|---|
match | 证据支持满足要求 | 1 |
partial | 只能支持部分要求 | 0.5 |
mismatch | 有明确不满足的证据 | 0;若为硬约束,候选总分直接为 0 |
uncertain | 资料不足,不能确定 | 有 uncertainScore 时使用 0~0.5;没有分值时不进入均分分母 |
保留 uncertain,是因为供给信息经常不完整。明确支持可换模具可以判 match,缺少粒度证据则应保留不确定。间接证据分帮助区分候选,但不能当作已确认满足。
逐项判定后,基础组和定制组分别求平均,再按 0.3 和 0.7 加权。提高定制组权重,是为了避免大量基础参数淹没关键定制要求,毕竟我们是定制结合方案,不是通用的匹配系统;基础正确性则由硬约束守住,以免要的是 T 恤 结果给了裤子这种情况。
baseScore   = 基础组可计分项得分之和 / 基础组可计分项数
customScore = 定制组可计分项得分之和 / 定制组可计分项数

存在 hard=true 且判为 mismatch 的项:候选分 = 0
否则:候选分 = (baseScore × 0.3 + customScore × 0.7) / 有效权重之和
某组无可计分项时,仅使用另一组并重新归一;两组都没有时返回 0。目前 0.3 和 0.7 是一个人为定义的权重,并没有经过系统的验证,只是我们在定制系统的背景下先直接定下来的,后续上线后有了真实的数据进来可以辅助我们进行调整(然而最终并没有上线)。
举例 Accio+Sourcing 第一候选的 13 项判断如下:
| 判定项 | 类型 | 硬约束 | 判定 | 分值 |
|---|---|---|---|---|
| 完整木炭压块生产线 | base | 是 | match | 1 |
| 中等产能 | base | 否 | partial | 0.5 |
| 包含烘干机 | base | 否 | partial | 0.5 |
| 支持多种炭块形状 | base | 否 | match | 1 |
| 可更换的定制模具 | custom | 是 | match | 1 |
| 适用木炭粉与煤粉 | base | 否 | match | 1 |
| 原料粒度不超过 5mm | base | 否 | uncertain | 0.3 |
| 原料含水率不超过 25% | base | 否 | partial | 0.5 |
| 380V/415V/440V 电压 | base | 否 | partial | 0.5 |
| 按电网要求定制电压 | custom | 是 | match | 1 |
| 海外工程师售后 | base | 否 | uncertain | 0.2 |
| 提供机器测试报告 | base | 否 | uncertain | 0.2 |
| 连续工作 | base | 否 | uncertain | 0.3 |
11 个基础项合计 6 分,2 个定制项合计 2 分,无硬约束冲突。实现先将组均值保留四位,再加权保留四位:
baseScore   = 6 / 11 → 0.5455
customScore = 2 / 2  = 1
候选分      = 0.5455 × 0.3 + 1 × 0.7 → 0.8637
最终两项定制要求得到支持,部分基础条件只有有限证据,最终得分 0.86 也是比较符合直觉。
第三步,按返回顺序计算这条 Query 的系统得分。
候选打分后,还要考虑位置:合适的商家排在第一位和第十位,对买家的价值是不同的。正式报告取有效候选的原序 Top 5,以 1/log₂(rank+1) 加权,靠前候选影响更大:
单 Query 系统得分 = Σ(Top K 候选分 × 排名权重) / Σ(排名权重)
排名权重          = 1 / log₂(rank + 1)
原序指清洗或导入后的顺序,不按 Judge 分数重排。执行失败的候选先过滤,不足 K 按实际数量计算,不补零,因此需同时保留失败与候选数量。
生产线案例的前五名如下。第二名得分更高,评测仍保留原序:
| 返回位置 | 候选分 | 位置权重(展示值) |
|---|---|---|
| 1 | 0.8637 | 1.000000 |
| 2 | 0.8855 | 0.630930 |
| 3 | 0.6750 | 0.500000 |
| 4 | 0 | 0.430677 |
| 5 | 0 | 0.386853 |
使用未截断权重,1.759888297 除以 2.948459119,得到 0.5969。后两名的不确定项均赋 0 分,一般都是有硬约束不满足。
最后,将多条 Query 汇总成系统结果。
最后对单系统的多 query 的评分结果直接去均值:
系统总分 = 该系统各条 Query 得分之和 / 参与比较的 Query 数量
系统得分 = 82.2451 / 114 → 0.7214
总分之外,再用三个指标检查可用候选、定制要求和关键错误:
| 指标 | 怎样计算 | 用来观察什么 |
|---|---|---|
| 系统得分 | 单 Query 的 Top K 位置加权分,再对共同 Query 等权平均 | 整体推荐质量与排序 |
| Precision@K | 每条 Query 的有效 Top K 中,候选分 ≥0.6 的比例,再按 Query 平均 | 靠前结果中有多少达到当前可用阈值 |
| 定制满足率 | 每条 Query 的全部未失败候选中,可计分 custom 项的平均分,再按 Query 平均 | 候选对定制要求的满足程度;范围不限 Top K |
| 硬伤率 | 每条 Query 的有效 Top K 中,硬约束明确冲突的候选比例,再按 Query 平均 | 是否推荐了违反关键条件的候选 |
二、从评测到匹配:复用判断能力,补上主动推荐
由于团队人员调整,我们随后接手了匹配系统。评测与匹配都要判断“给定需求和能力证据,商家能否承接”,所以需求拆分、画像、Judge 和候选计分可以复用,只需要增加主动召回和推荐排序。而我们原本在获取每个系统的不同匹配结果时,其实已经做了对单 query 的结果获取,只需要根据我们评测系统的打分进行一次重排就可以了。
2.1 匹配系统实现
拆分得到的品类、硬约束和定制条件,既能指导 Judge,也能指导搜索。但全部条件塞进一条搜索词容易限制召回,我们将品类和关键硬诉求作为共用部分,软诉求分组,形成多路搜索。召回后按商家去重、补画像并逐项判断,过滤硬约束冲突与执行失败,再按候选分降序、输入排名升序取 Top 5(暂定的 5 ,也可以随时调整)。
评测用候选分评价已有顺序,匹配用候选分生成新顺序。 生产线案例的第二候选得分更高,评测保留原序,匹配则可以将它排到前面。判断规则没有变化,使用分数的方式变了。
这条流程封装成 Sourcing Skill,接收需求原文和结构化补充,分阶段执行:
init → split → search → enrich-judge → build
初始化   拆需求   多路召回   补画像并逐项判断   计分并生成推荐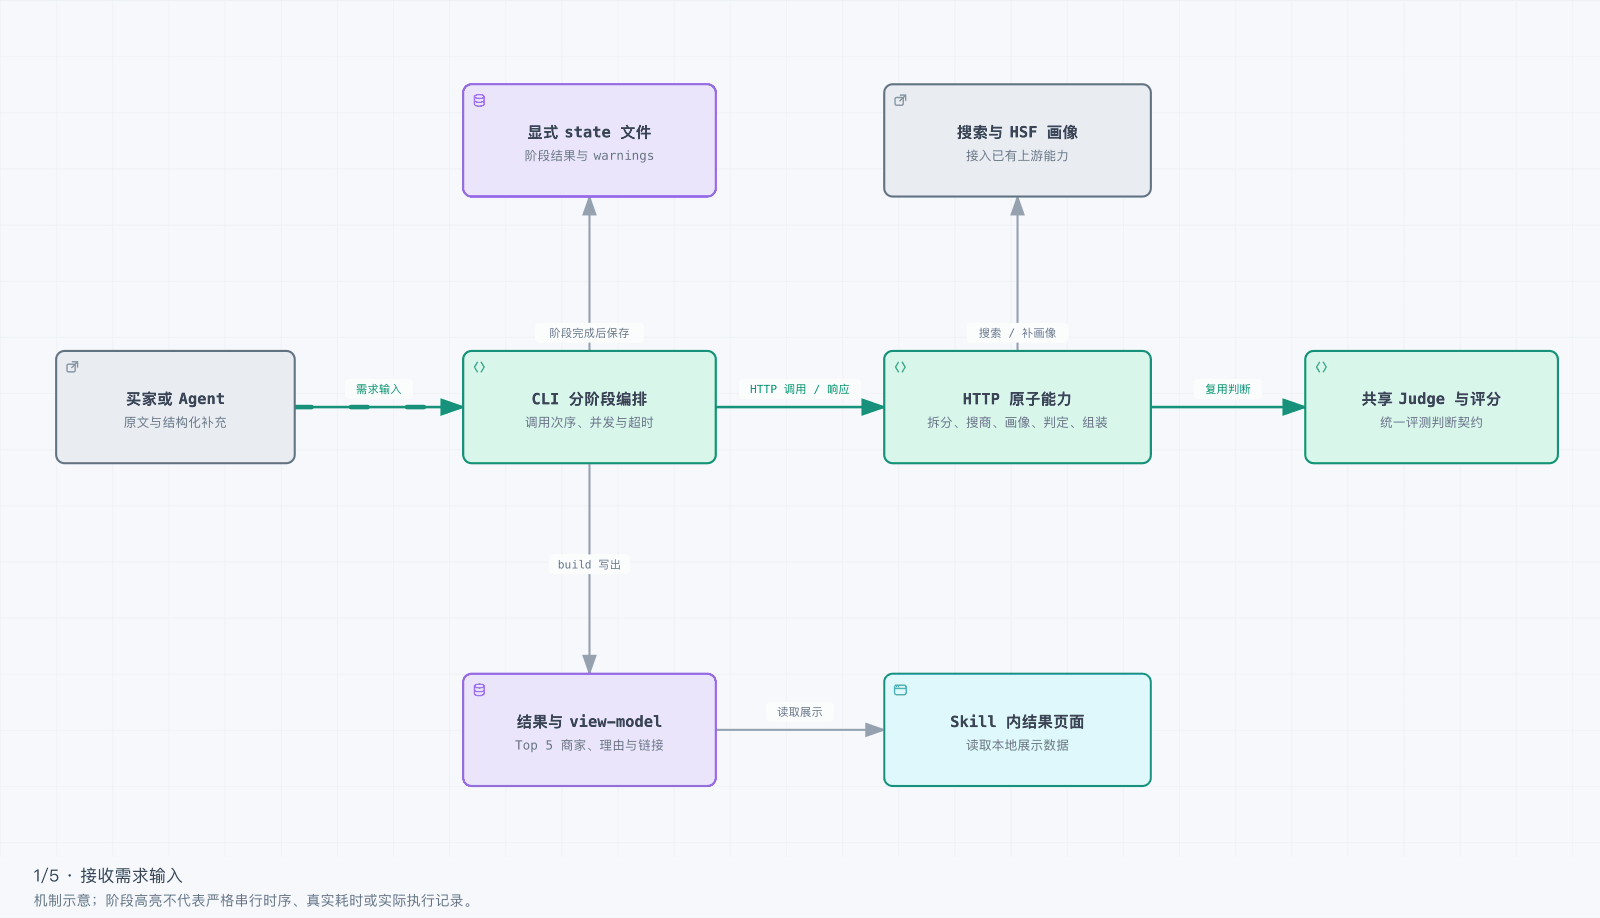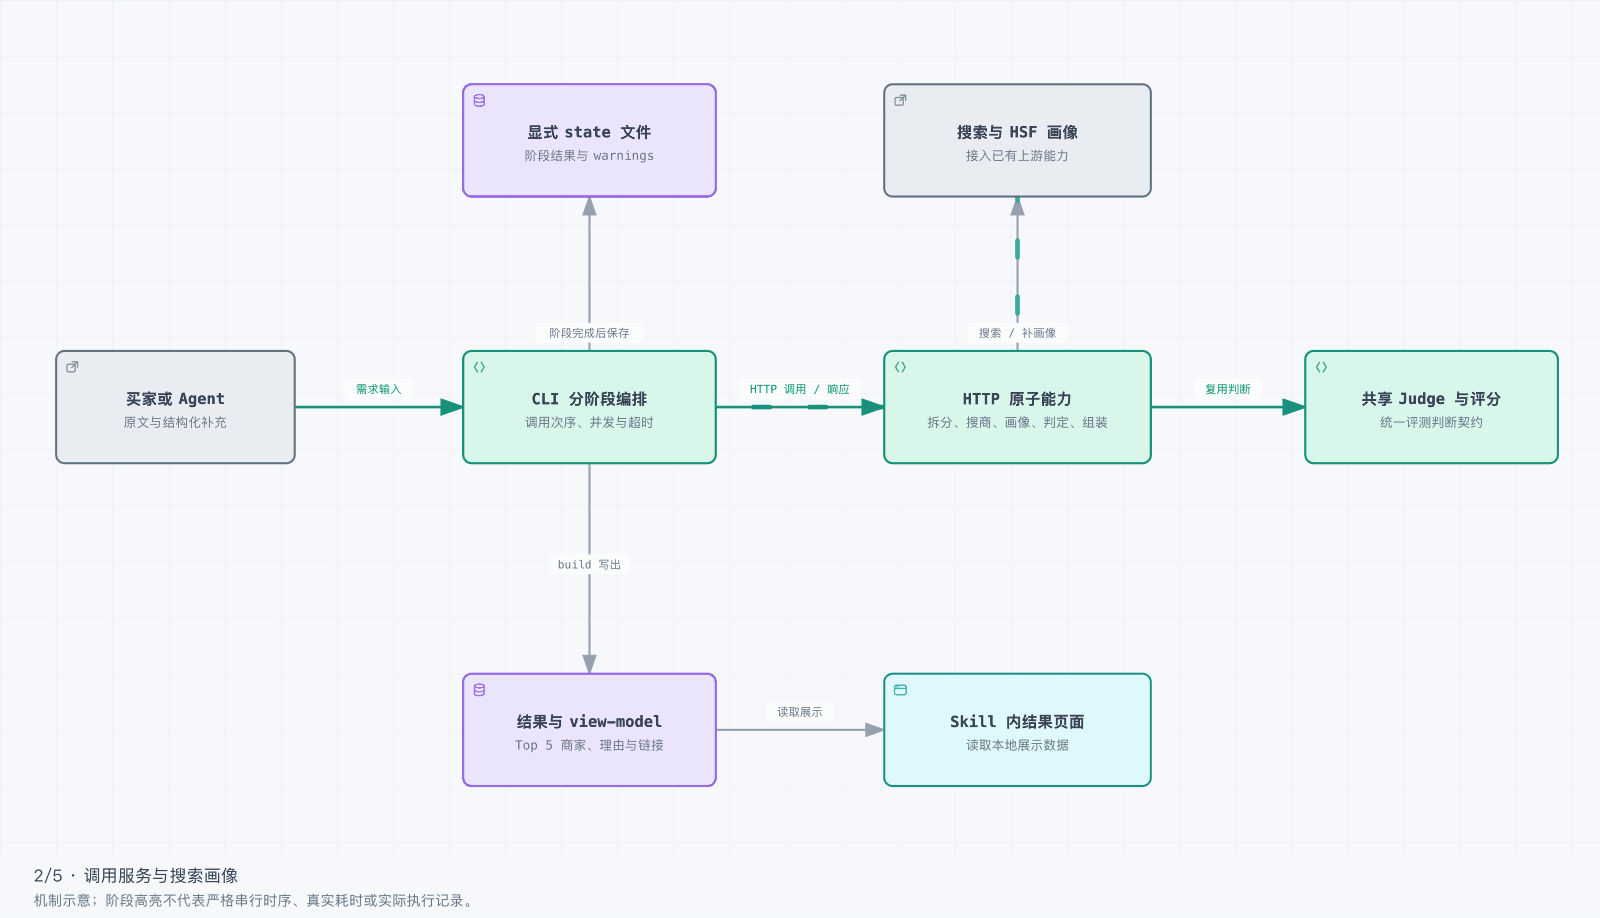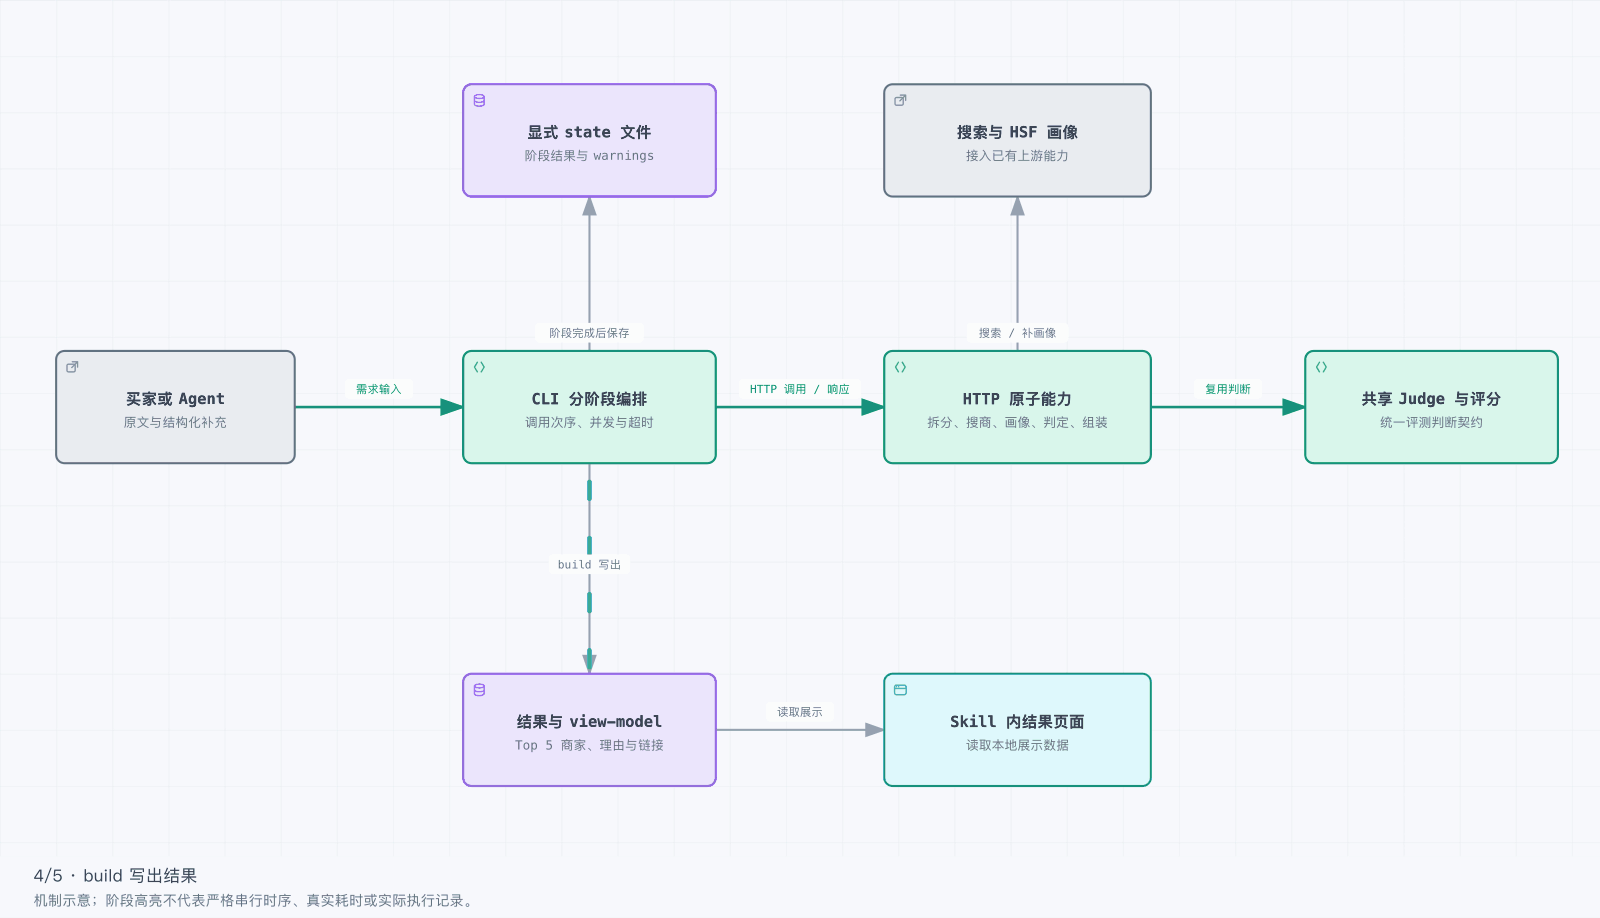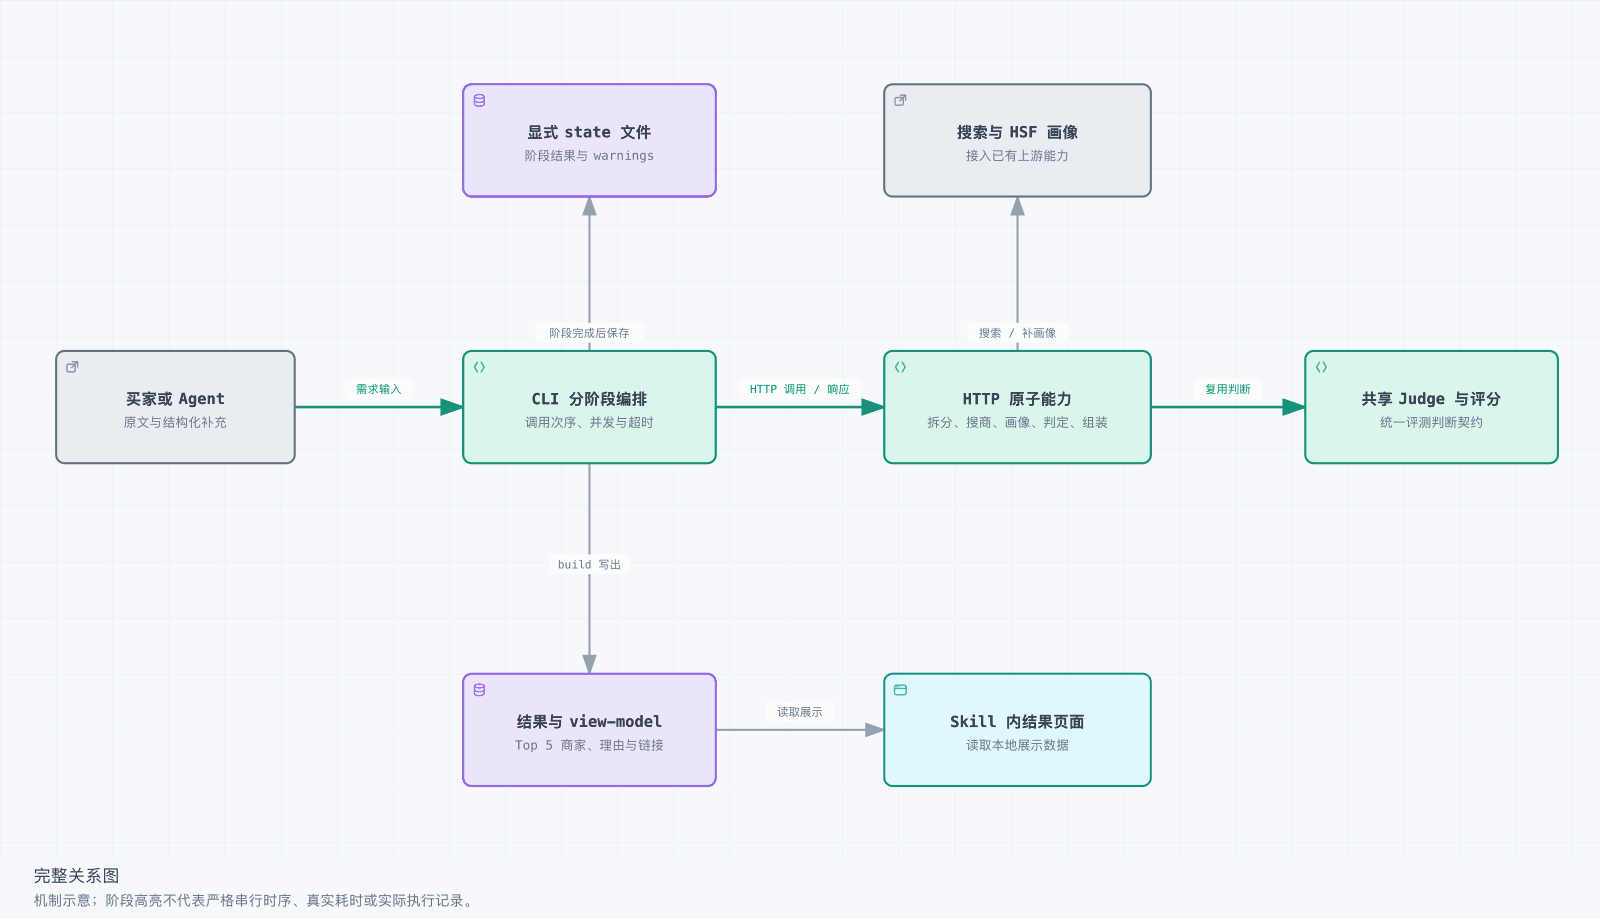
由于我们的原型系统部署在 FaaS 上,连续调用搜索、画像和模型服务容易超过单次 FaaS 时限,因此由调用端安排阶段顺序、并发和保存,服务端复用已有业务实现,保留中间结果供排查。
基于这个思路我们开发了 Sourcing Skills 以及后面的匹配系统,开发完以后使用我们的评测系统进行评测,得到的三方结果如下,也可以查看 https://backroom.fn.alibaba-inc.com/eval-compare 系统报告:
| 系统 | 系统得分 | Precision@K | 定制满足率 | 硬伤率 |
|---|---|---|---|---|
| Accio+Sourcing | 0.7214 | 71.2% | 58.1% | 6.4% |
| Claude Local+Sourcing | 0.7380 | 75.1% | 60.3% | 6.2% |
| AccioWork | 0.3297 | 28.3% | 25.4% | 2.3% |
两个 Sourcing 组合整体接近,在当前样本上相对单 AccioWork 有很大的优势。说明我们的这套匹配系统的效果是很不错的,但是虽然最终得分比较高,但是整体的匹配耗时变成了,一次匹配需要 5min 左右,相较于 AccioWork 大概在 2min 左右,我们慢了整整一倍多。
2.2 耗时优化:减少批次等待,缩短单次推理
一次匹配要对几十个商家补画像并判断,耗时达到分钟级。这个对于离线评测问题不大,但是对于匹配系统来说需要更快响应。拆看阶段耗时后,我们做了三项调整。
一是减少整批等待。 原先全部画像补完才进入 Judge,慢请求会拖住所有候选。调整为 enrich-judge 后,每批画像就绪便进入判断,各批同时推进。
二是裁剪无关输入。 原本的定制画像有非常多的冗余数据,对于我们评测匹配来说不需要,但是会占用模型上下文并导致模型响应变慢,所以移除 buyerDemandsAgg 等低相关性字段,保留 SKU、关键属性与定制能力,减少模型处理的内容。
三是调整批量大小。 每次放入更多商家虽能减少请求,却会增加输入输出长度,拉长单次推理。商家流程由每批 10 家改为 5 家,40 家分成 8 批,在当时的 10 Key 池内并发;
最终的实际的优化效果,单次测试从 4.1min 下降到 2.9min ,效果虽然比较显著,但是依然还是太慢了对于实时匹配诉求来说,没有用户愿意坐在电脑前等待 3min 。
| 测量范围 | 主要调整 | 优化前 → 优化后 | 耗时下降 |
|---|---|---|---|
40 家商家的 enrich-judge 阶段 | Judge 批次 10→5,8 批并发 | 247→176 秒,约 4.1→2.9 分钟 | 28.7% |
2.3 耗时优化:微调小模型方案
于是我进一步考虑,让小模型承担职责稳定的理解和判定任务。毕竟,输入输出已经明确,7B 或 14B 量级可能就能满足诉求,当时方案以 Qwen3-8B 为起点,尝试降低推理时延和成本。
模型承担两个任务:Query 输入后,一次输出判定项和采购意图;需求、条件和单商家画像输入后,输出逐项状态、理由与证据。召回、画像、硬约束后处理及计分仍由程序负责,便于分别替换模型、检查变化。
原有评测集与 Judge 结构化输出可以整理成教师样本,已经导出微调需要的数据:
| 数据 | 数量 | 内容 |
|---|---|---|
| 需求理解样本 | 115 条 | Query、判定项与采购意图 |
| 商家判定样本 | 1,092 条 | 需求与单商家画像,以及 opus 教师生成的状态、理由和证据;来自 Claude Local 的 548 条与 Accio+Sourcing 的 544 条 |
当时已准备评测集、教师输出和 JSONL 数据,尚未划分独立训练、验证与测试集。原计划下一步需按 Query 及重复文本分组,避免同一需求的商家样本跨训练与测试;人工校准教师判断后,再固定候选和画像比较模型质量、时延与成本。
但是后来产品方向转向 POD,这条路线停在数据与方案准备阶段,未继续训练、部署和验证降本效果。
三、总结
回头看,虽然最终项目没有上线,但是我们整套评测系统和匹配方案还是很完整的,后续有类似的项目也可以借鉴,并且从中学习到了如何设计一个评测系统,还是受益匪浅。
附录
以下系统与语雀链接需要公司内网访问。
- 补充:RFQ 分析的数据加工图